
系列:30 天打造企業級 PLM|面向:後端|素材:壓測套件(k6 + Node)
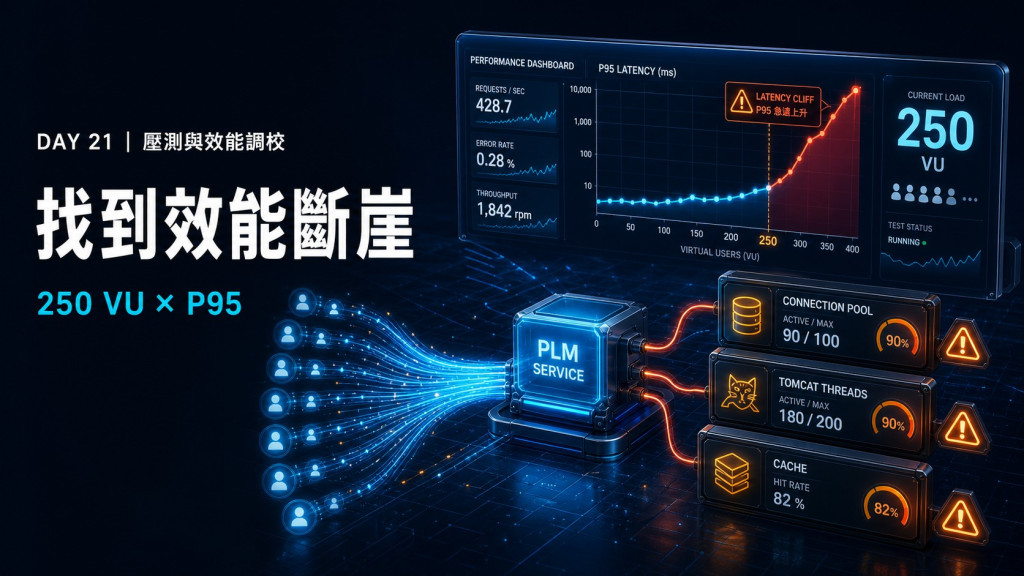
上線前最怕的一句話:「這系統撐得住全公司同時用嗎?」沒壓測過的答案都是猜的。Mini-PLM 在上線前建了一套可重跑的壓測套件,驗證兩個效能維度:200+ 人併發,以及 BOM 1000+ 筆的大表操作。今天講方法、講發現,也講那兩個被壓測抓出來的秒級熱點怎麼修。
以前在 Oracle Agile PLM 的維運經驗中,效能調校基本上是一門「黑魔法」:
Mini-PLM 採用扁平且透明的現代輕量技術棧:沒有 EJB 容器的層層中介,效能核心只看三個關鍵指標——HikariCP 資料庫連線池、內嵌 Tomcat 執行緒與 JPA 批次/原生 SQL,瓶頸在哪裡一清二楚。
單一情境的壓測會騙人,因為真實負載是混合的。套件的組合拳(實際執行流程):
# 1. 建 200 個壓測帳號(SSE 每帳號上限 3 條連線,必須獨立帳號)
node seed-perf-users.mjs --count=200
# 2. 建 BOM 測試資料(60 葉件+12 子組件+3 頂層+1000 筆平面 BOM,共 1510 筆)
node seed-bom-perf.mjs
# 3. 單請求延遲基準(平面 1000 筆讀取、全樹展開、redline 200 筆變更)
node bom-redline-perf.mjs
# 4+5.(同時)監控快照收集 + SSE 長連線 200 人 × 3 條常駐
# 6. k6 混合情境:smoke 驗證 → fast 找斷崖(90s/階,50→250)→ full 撐穩態(4m/階)
這套流程裡有幾個刻意的安排。
「找平均值」的壓測只回答有沒有過門檻;「找斷崖」的壓測回答什麼時候開始壞、誰先倒。階梯式加壓(50→250 VU)盯三個嫌疑人:
pending 開始持續大於 0,代表 API 在排隊等連線,這通常是第一個倒的。結果:250 VU 無斷崖。P95 在門檻內、Hikari pending 恆為 0、heap 不持續攀升。這句話能說出口,靠的是第 4 步的監控快照(pool / SSE / heap / 區間 RPS 與延遲)跟壓測同步收集——沒有監控數據的壓測結論只有「過/不過」,有監控才有「為什麼」。
單請求基準測試(第 3 步)抓出兩個秒級操作:
| 熱點 | 原因 | 修法 | 出處 |
|---|---|---|---|
| BOM 掛載 2.8s | 整樹逐筆 ORM 複製 | BomBulkCopyDao INSERT-SELECT |
Day 14 |
| Redline 批次 5.3s | 逐筆 save 的 dirty checking | saveAll 批次化 |
Day 15 |
共同病因是 ORM 逐筆操作被拿去做批次工作。壓測的價值不只在發現慢,更在給出「多慢、慢在哪一步」的數字。沒有 2.8s 這個數字,「BOM 掛載好像有點慢」永遠排不進工作清單。我試過,真的排不進。
PERFW-* 料號與 CANCELLED 表單,所以 README 直接寫明「正式環境禁止執行」。壓測資料要有可辨識前綴,事後才清得掉。回頭看這套壓測,最值錢的地方是它可以重跑:負載有真實形狀(混合流量加上長連線常駐)、門檻在測試前就定好、斷崖配著監控快照一起看,熱點也因為有了數字才排得進修復清單。上線前的功課做完了,上線後呢?明日 Day 22:監控維運,讓系統自己說話。


 iThome鐵人賽
 看影片追技術